introducción
apache kafka es una plataforma distribuida para manejar eventos en tiempo real: permite enviar, almacenar y consumir flujos de datos de forma fiable y escalable.
a diferencia de una cola “simple”, kafka persiste los eventos en un commit logparticionado y replicado. eso habilita alto rendimiento, reprocesamiento y tolerancia a fallos.
demo: flujo producer → tópico → consumer
presiona enviar evento en “usuario” y observa cómo se agrega al final del tópico; inicia consumir en “kafka consumer”.
interactúa → producer
lee en streaming
conceptos
- topic: categoría donde se publican eventos.
- partición: división del topic para paralelismo y throughput.
- réplica: copia de una partición (líder + seguidores) para tolerancia a fallos.
- broker: servidor kafka que almacena y entrega particiones.
- producer: servicio que envía eventos al topic.
- consumer: servicio que lee eventos, usualmente en grupos.
particiones y réplicas
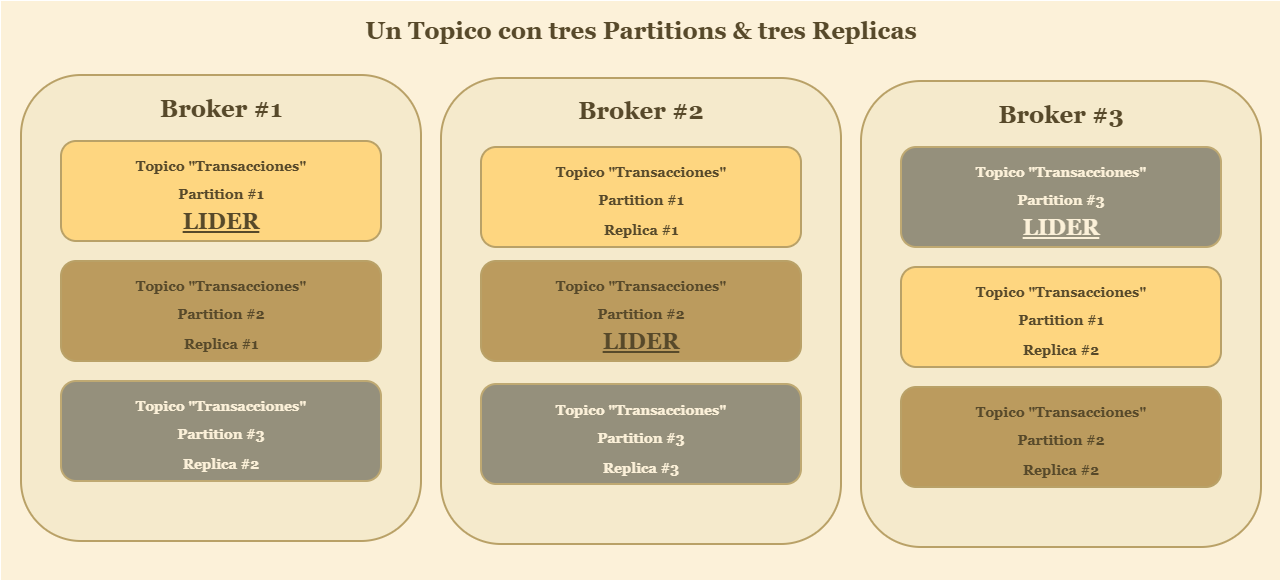
cada partición tiene un líder que acepta escrituras y una o más réplicas seguidoras. si el líder falla, una réplica elegible asume el liderazgo.
grupos de consumidores
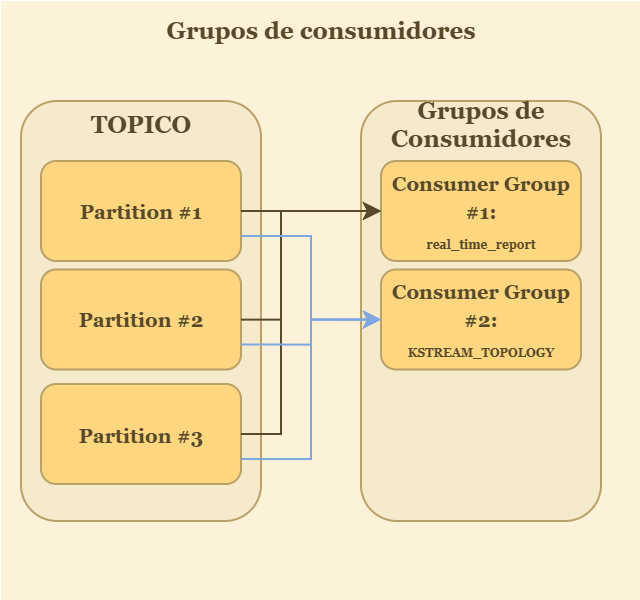
los consumidores se organizan en grupos. dentro de un grupo, cada partición es leída por un único miembro (balanceo automático). varios grupos pueden leer el mismo topic de forma independiente.
demo avanzada: particiones, key hashing y consumer group
envía eventos con o sin key (la key dirige la partición). cambia los miembros para provocar rebalance. observa el lag y los offsets comprometidos por partición.
last − committed.replicación entre brokers (y regiones)
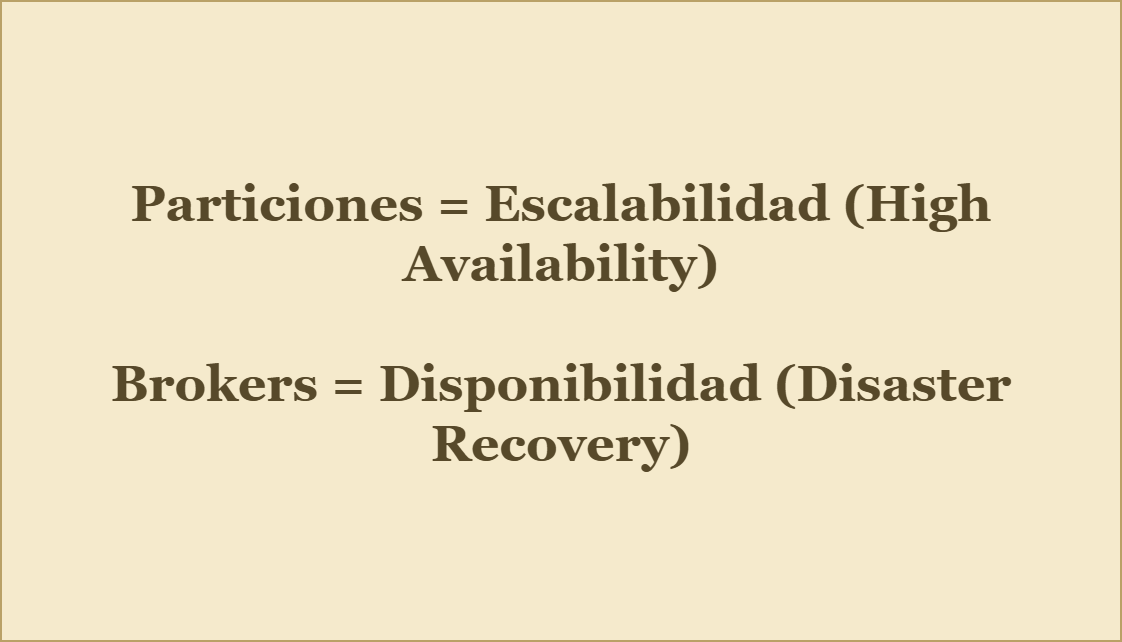
la alta disponibilidad se logra replicando particiones en brokers distintos; en algunos despliegues, incluso en zonas/regiones diferentes para DR.
resumen visual
¿por qué usar kafka?
- alto throughput y latencia baja para eventos en tiempo real.
- persistencia y reprocesamiento: relees histórico cuando quieras.
- tolerancia a fallos con réplicas y liderazgo.
- escalado horizontal por particiones y por consumidores en grupo.
- ecosistema completo: connect, streams, ksql, esquema/serde, etc.